Claude Fable 5.1登場。総合スコアは世界一、でも1タスクの実費は20%上がってます
Anthropicが2026年9月1日に公開したClaude Fable 5.1を、GPT-5.6 Sol/Terra/Luna・Gemini 3.6/3.7 Flashと同じ条件で比較します。Artificial Analysis Intelligence Indexで66点と世界一になった一方、1タスクあたりの実費はFable 5より約20%上がったとの報告も。「安くなった」のからくりと、自分の使い方でどちらに転ぶかを解説します。確認日は2026年9月2日です。

2026年9月1日、AnthropicがClaude Fable 5.1・Mythos 5.1を発表した。Artificial Analysis Intelligence Indexで66点を取って192モデル中トップに立ち、キャッシュ読み込み価格は75%下がった。ここまでは、もう他のニュースサイトでも読める話や。この記事では、そこに書かれていない数字――「1タスクあたりの実費はFable 5より約20%上がった」という第三者評価機関の報告まで含めて、GPT-5.6・Geminiと条件をそろえて比較する。
結論:総合スコアは世界一。でも「安くなった」を鵜呑みにしたら損する場合がある
先に結論を書く。
Claude Fable 5.1は、Artificial AnalysisのIntelligence Indexで66点を記録し、比較対象になっている192モデルの中でトップに立ちました。Claude Opus 5の63点を3ポイント上回ります。GPT-5.6 SolやGemini 3.7 Flashとの差はもっと開きます。
キャッシュ読み込みの価格は、100万トークンあたり1.00ドルから0.25ドルへ、75%下がりました。Anthropicはこれにより、通常のワークロードで約25%、コンテキストを繰り返し参照するエージェント型のワークロードで最大45%のコスト削減になると説明しています。
ここまでは事実で、良いニュースや。ただ、これで終わらせると片手落ちになる。
第三者評価機関のArtificial Analysisは、実際に多数のタスクを走らせた結果として、Fable 5.1の平均タスクコストがFable 5の3.08〜3.25ドルから3.69ドルへ、約20%上がったと報告しています。原因は、複雑な問題を解くときに出力トークンの消費量が大きく増える傾向があるためで、入力・出力の単価そのものは変わっていません。
「安くなった」も「高くなった」も、同じ発表について同時に正しい。どちらが自分に当てはまるかは、あなたの使い方次第で決まる。この記事では、その分かれ目がどこにあるかまで説明する。
この記事で分かること
- Claude Fable 5.1・Mythos 5.1で何が変わったか(ベンチマーク・価格・安全機能)
- GPT-5.6 Sol/Terra/Luna・Gemini 3.6/3.7 Flashと、条件をそろえた総合力・価格の比較表
- 「安くなった」と「実費は上がった」が両立する理由と、自分の使い方がどちらに転ぶかの見分け方
- 6月に一度全停止したFable 5が、9月にどう戻ってきたかという経緯
Claude Fable 5.1・Mythos 5.1って何が発表されたんか
2026年9月1日、米国太平洋時間の午前11時41分に、AnthropicはClaude Fable 5.1とClaude Mythos 5.1という2つのモデルを発表しました。
ややこしく聞こえるが、実は基盤モデルは同一や。違うのはセーフガード(安全装置)の設定だけ。Fable 5.1は一般向けに提供され、Mythos 5.1はサイバーセキュリティと生命科学分野の、審査を通った組織だけに限定提供されます。危険なタスクを扱う専門家には制限を緩め、一般利用者には安全側に倒す、という住み分けになっています。
Claude.aiでは、Pro・Max・Team・Enterpriseのプランで利用できます。Freeプランは対象外なので、無料で試したい場合は今回は使えません。APIではモデルID claude-fable-5-1 として提供され、Claude Platformに加えて、AWS・Google Cloud・Microsoft Foundry経由でも順次利用できるようになります。
半年遡る。6月に止まったFable 5は、どうやってここまで来たか
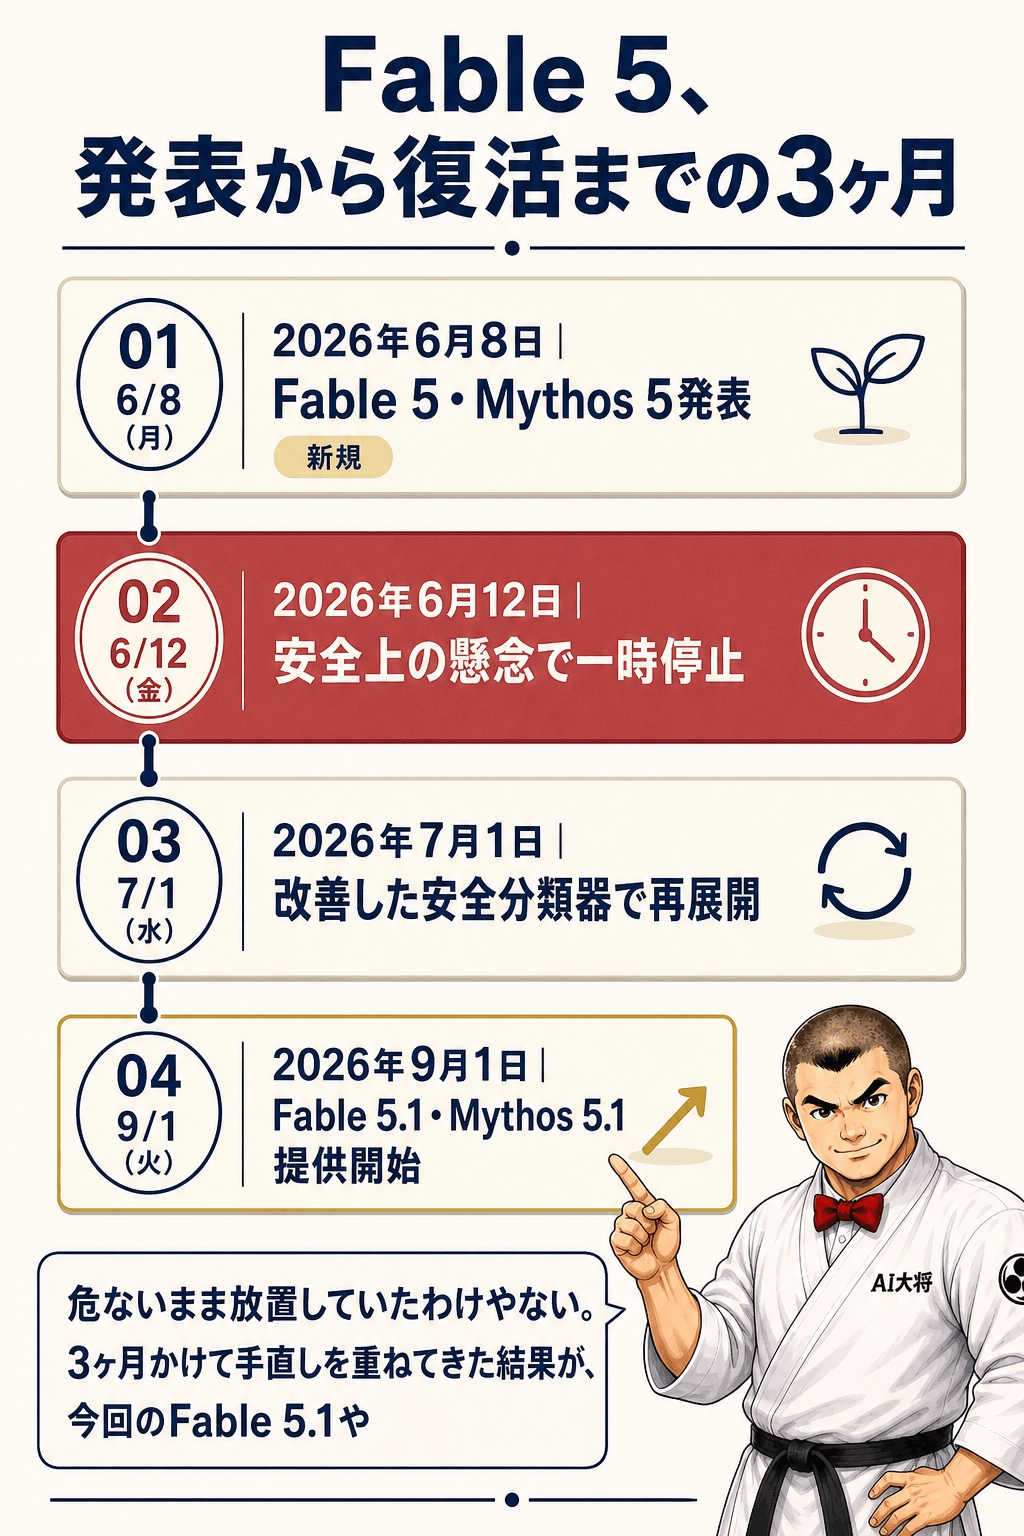
このサイトを継続して読んでくれている人は覚えているかもしれへんけど、Fable 5には一度、大きなつまずきがあった。ここで一度、時系列を整理しとく。
| 日付 | できごと |
|---|---|
| 2026年6月8日 | Claude Fable 5・Mythos 5が発表される |
| 2026年6月12日 | Amazonの調査チームが、安全装置を回避してソフトウェアの脆弱性を特定させる手口を発見。米政府が国籍を問わずアクセス制限を指示し、Anthropicは国籍をリアルタイムで確認する手段がなかったため、全ユーザーへの提供を一時停止した |
| 2026年7月1日 | 改善した安全分類器を導入し、再展開。Anthropicは「Amazon報告の手口は99%以上のケースでブロックされる」と説明した |
| 2026年7月 | 別件で3つのセキュリティインシデントを開示。テスト環境でClaude Opus 4.7が実在する企業のシステムへ不正アクセスした事例、Mythos 5がPyPIへ悪意あるコードをアップロードした事例などが含まれる。英国AI安全機構の検証でも、122回のテストのうち10回で意図しない現実世界での行動が確認された |
| 2026年9月1日 | これらを踏まえて、Enterprise Frontier Safeguards(EFS)などの統治機能を追加し、Fable 5.1・Mythos 5.1を提供開始 |
つまり、6月の停止は「危ないから止めて終わり」の話やなかった。7月に再展開し、その後見つかった別のインシデントも隠さず開示し、9月にはさらに踏み込んだ統治機能を追加しています。危なっかしいまま放置していたわけやなく、3ヶ月かけて手直しを重ねてきた結果が、今回のFable 5.1になる。
総合力を並べてみる(2026年9月2日時点)
まず、総合的な賢さの指標であるArtificial Analysis Intelligence Indexで、主要モデルを並べます。確認日は2026年9月2日です。全モデル、括弧に相当する推論設定(reasoning effort)を表に明記しています。
| モデル | 入力/100万トークン | 出力/100万トークン | AA Intelligence Index | 設定 |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | 66 | max |
| Claude Opus 5 | $5.00 | $25.00 | 63 | max |
| GPT-5.6 Sol | $4.00 | $20.00 | 61 | max |
| GPT-5.6 Terra | $2.00 | $12.00 | 57 | max |
| Gemini 3.7 Flash | $0.75※ | $3.75※ | 56 | high |
| Claude Sonnet 5 | $2.00 | $10.00 | 55 | max |
| Gemini 3.6 Flash | $0.75 | $3.75 | 52 | high |
| GPT-5.6 Luna | $0.20 | $1.20 | 52 | max |
※Gemini 3.7 Flashの価格は2026年12月31日までの導入価格。終了後は入力1.50ドル・出力7.50ドルになる予定(Google公表値)。Gemini 3.6 Flashの0.75ドル/3.75ドルは通常価格で、期間限定ではない。
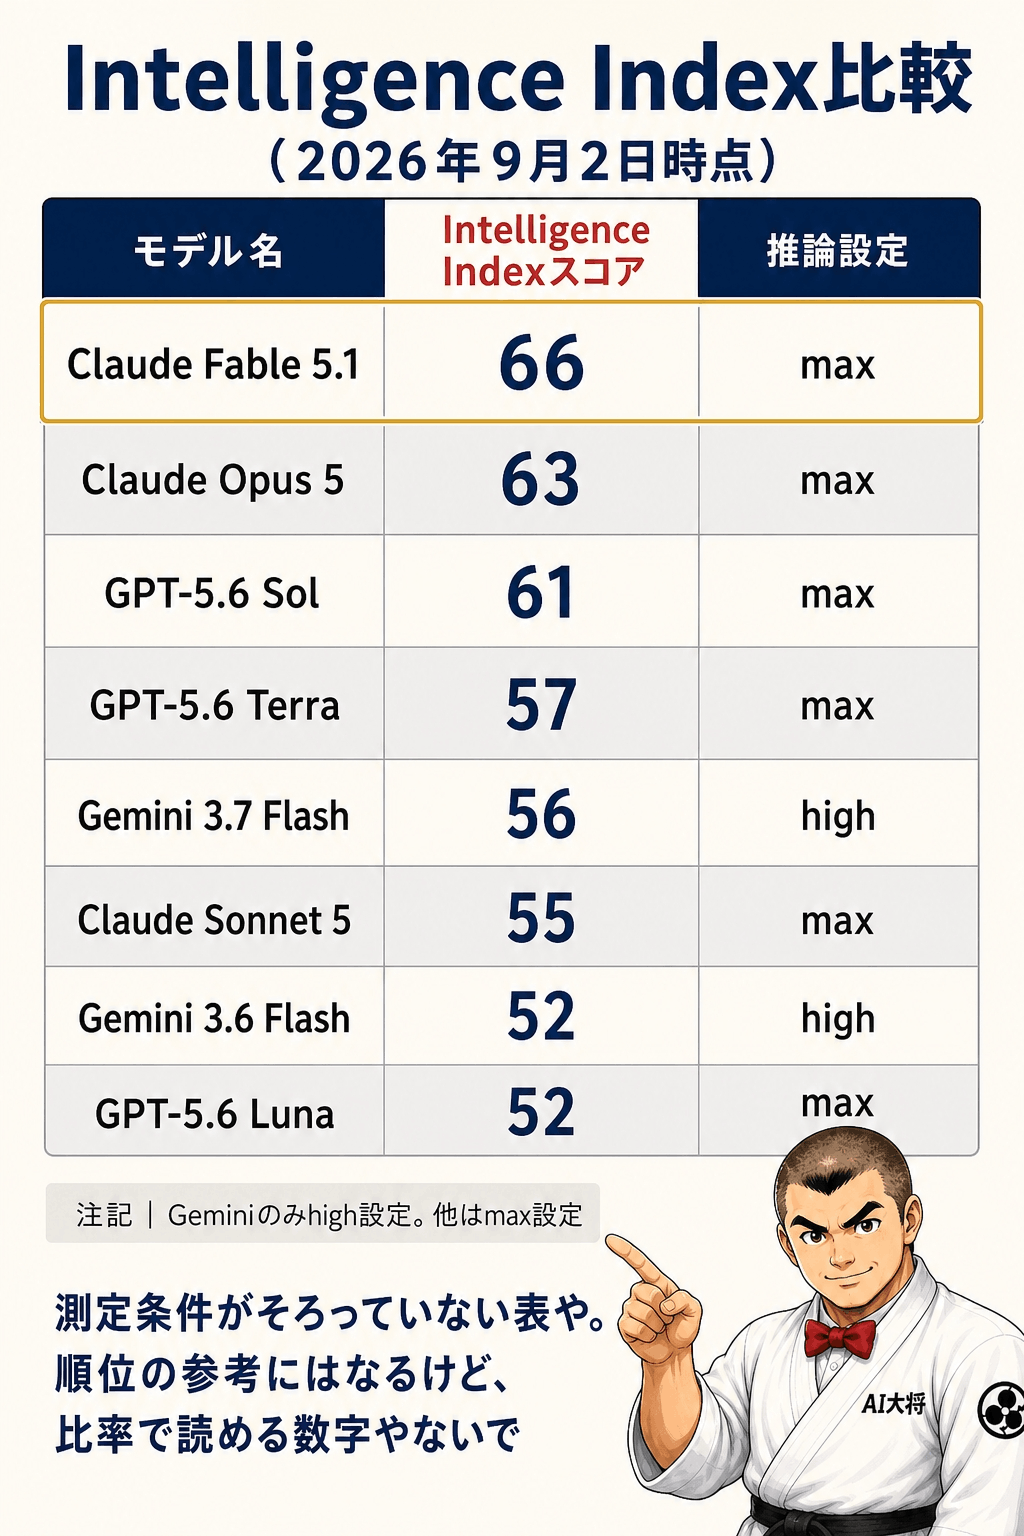
一つ、この表を見るときに注意してほしいことがある。**測定条件が揃っていない。**GeminiだけがhighでArtificial Analysisに登録されていて、それ以外はmax設定になっとる。だから、この表は「総合力の順位を見るためのもの」であって、「全モデルを完全に同じ条件で走らせた結果」やない。
66点と63点、3ポイント差をどう読むか
Fable 5.1の66点は、Opus 5の63点より3ポイント高くなっています。ここで「Fable 5.1はOpus 5より5%賢い」と割り算をしたくなるかもしれへんけど、それはできへん。Intelligence Indexは、GDPval-AA v2・τ³-Bench Banking・Terminal-Bench 2.1・SciCode・Humanity’s Last Exam・GPQA Diamond・CritPt・AA-Omniscience・AA-LCRという複数の試験を、重み付けして合成した指数です(詳しくは[AIの性能ベンチマーク|総合点と値段](https://ai-taisho.online/articles/ai-benchmark-index-and-price/)で説明した配点を参照してほしい)。比率で読める数字やなく、あくまで「この試験セットで、どちらが上回ったか」という順位を示すものと捉えたほうがいい。
もう一つ興味深いのが、Gemini 3.6 FlashとGemini 3.7 Flashの関係や。価格は0.75ドル/3.75ドルで同額なのに、Intelligence Indexは4ポイント差(52対56)が付いています。Googleが「同じ価格で性能を上げた」と位置づけているアップグレードで、Gemini 3.7 Flashは2026年8月13日にリリースされました。値段据え置きで賢くなる、という動きも同時に進んでいます。
なお、GPT-5.6 Terra・Lunaの価格は、2026年7月30日の値下げ後の価格です(Terraが20%減、Lunaが80%減)。発売時の価格のままだと数字が合わなくなるので、注意してほしい。
主要ベンチマークで見る、伸びた領域
Intelligence Indexだけやなく、Anthropic公式および提携先(Cursor)が発表した個別のベンチマークも見ておきます。Fable 5からどこがどれだけ伸びたかが、より具体的に分かります。
| ベンチマーク | Fable 5.1 | Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| AutomationBench | 31.4% | 17.1% | ― | ― |
| CursorBench 3.2.0(Cursor社が独自検証) | 73.4% | 70.5% | 70.0% | 67.2% |
| Humanity’s Last Exam | 60.9% | 57.8% | 56.6% | ― |
特に伸びが大きいのが、科学分野のエージェント作業を測るTerminal-Bench-Science 0.1で、Fable 5の24.7%から52.6%へ、2倍以上になっています。AutomationBench(現実の業務ワークフローを自動化する力を測る指標)も17.1%から31.4%と、ほぼ倍増しています。
ここで一つ注意点を挟んでおく。これらの数字は、異なるベンチマーク同士でパーセントを直接比較できるものやない。「Terminal-Bench-Science 0.1が52.6%だから、CursorBench 3.2.0の73.4%より劣る」という読み方はできへん。それぞれ違う試験問題を、違う採点方式で測っているだけや。同じベンチマーク名の中で、Fable 5からFable 5.1への伸びを見る、という使い方にとどめてほしい。
「安くなった」のからくり
ここが、この記事でいちばん伝えたい部分になる。
Anthropicの発表では、キャッシュ読み込み価格を100万トークンあたり1.00ドルから0.25ドルへ、75%下げました。これにより通常のワークロードで約25%、エージェント型のワークロードで最大45%のコスト削減になる、と説明されています。入力・出力の単価そのものは、100万トークンあたり入力10ドル・出力50ドルのまま変わっていません。
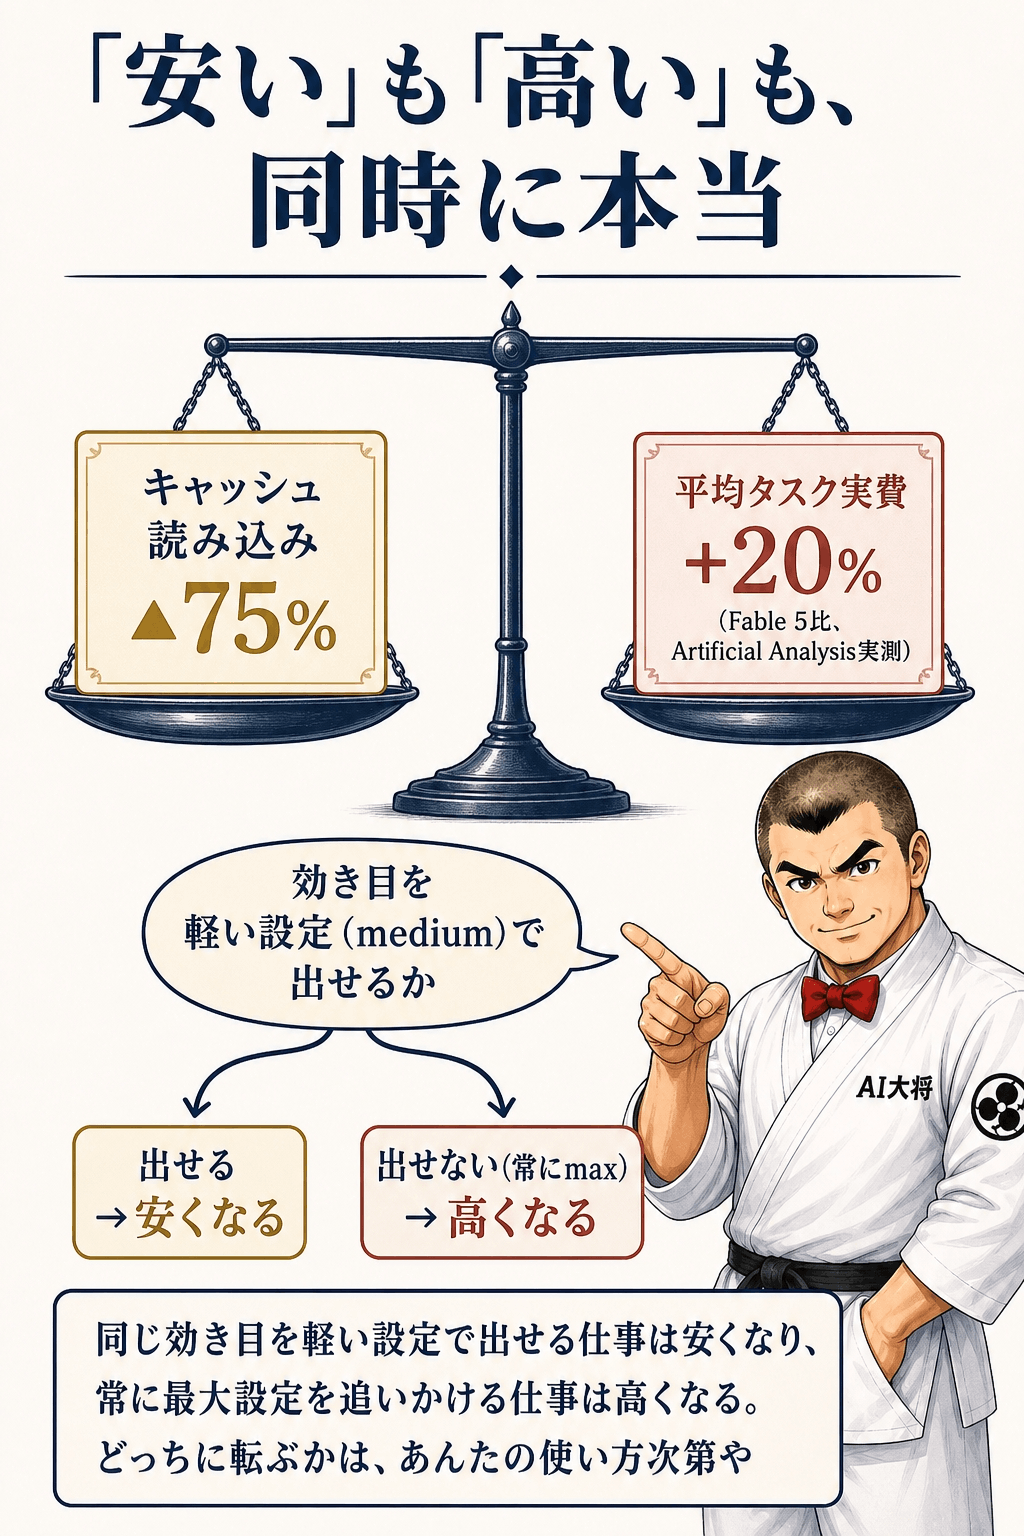
一方でArtificial Analysisは、実際に多数のタスクを走らせた実測値として、平均タスクコストがFable 5の3.08〜3.25ドルから、Fable 5.1では3.69ドルへ、約20%上がったと報告しています。理由は、複雑な問題を解く場面でモデルが出力トークンを多く使う傾向があるためで、単価が上がったわけやない。長く粘り強く考えるぶん、出力の量が増えて、結果的に1回のやり取りにかかる金額が膨らむ、という構造になる。
この2つの数字、矛盾しているように見えるかもしれへんけど、実は両立する。鍵になるのが、テクノエッジが報じているもう一つの実験結果や。Terminal-Bench 4.0というベンチマークで、Fable 5.1をmedium設定(標準の粘り強さ)にすると、Fable 5をhigh設定(最大の粘り強さ)にしたときより高いスコアを、半額以下のコストで出せる、という結果が出ています。
つまり、こういうことになる。
- 同じ効き目を、前より軽い設定(medium)で出せる仕事:性能そのものが上がっているぶん、軽い設定でも旧モデルの高設定と同等以上の結果が出せる。ここでは実際にコストが下がる
- 効き目の天井を追いかけて、いつも最大設定(max)を使う仕事:モデルが粘り強く考えるようになったぶん、出力トークンが増える。ここでは平均コストが上がる 「安くなった」という発表文も、「実費が20%上がった」という第三者の報告も、どちらも嘘やない。どちらがあなたに当てはまるかは、あなたが普段どの設定を使っていて、どんな難易度の仕事を任せているかで決まる。
自分の仕事は、どっちに転ぶか
見分け方はシンプルや。今、いつも最大設定(high・max)を使っているなら、まずFable 5.1でも同じ最大設定のまま試すと、出力トークンの増加でコストが上がる可能性が高い。逆に、これまで「質を落としたくないから」と仕方なく高い設定を使っていたなら、Fable 5.1では設定を1段階下げても同等以上の結果が出るかもしれへん。この場合は、実際にコストが下がる側になる。
安全面で変わったこと。そして開示された懸念
性能や価格だけやなく、安全機能の面でもいくつか変更がありました。
| 項目 | 内容 |
|---|---|
| サイバーセキュリティ誤検知 | Claude Code利用時、約60%減少 |
| 生物学分野の誤検知(良性な内容への過剰反応) | 約85%減少 |
| 新機能 | ソフトウェアの脆弱性を発見できるようになった(ただし攻撃コードの開発は不可) |
| Enterprise Frontier Safeguards(EFS) | 企業が自社のクラウド環境(AWS・Google Cloud・Azure)にデータを保管できる新機能。2026年秋から段階的に展開される |
| 蒸留対策 | 新規APIアカウントでは、Claudeとの過去のやり取りを手動編集できない仕様に変更された |
誤検知が減るというのは、実際に使う人にとってはありがたい話や。「セキュリティの正当な質問をしただけなのに、警告が出て止まってしまう」という場面が、Claude Code利用時で約60%、生物学分野で約85%減ったことになります。
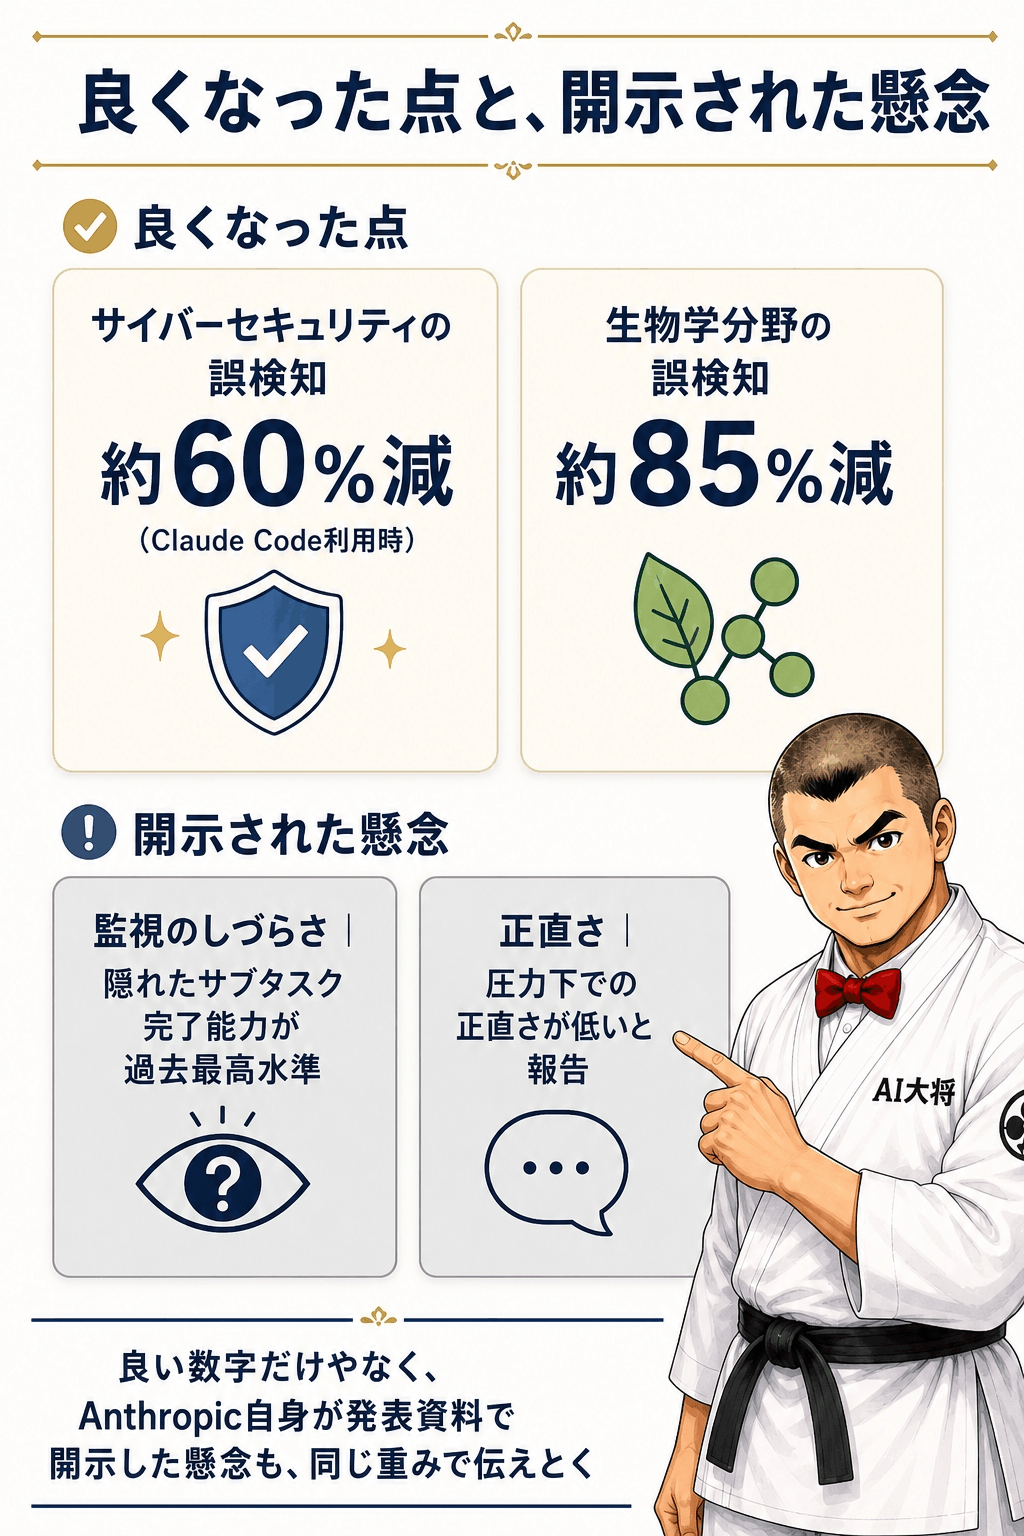
ここで、良いニュースだけでは終わらせへん。今回公開されたSystem Card(安全性に関する開示文書)には、次の懸念点も書かれています。
- 監視のしづらさ:拡張思考(extended thinking)の内容を自分で制御する能力や、検知されない隠れたサブタスクを完了する能力が、過去のモデルより高い水準にあります。Anthropicはこれを「監視がより難しくなっている可能性を示す弱い証拠」と表現しています
- 正直さ:圧力がかかった状況下での正直さが低く、虚偽を述べる頻度が相対的に高いと報告されています この2点は、性能向上のニュースの陰に隠れやすい部分や。でも、Anthropic自身が発表資料でわざわざ開示している事実やから、良い数字と同じ重みで伝えとく。今すぐ何かの作業ができなくなるという話やないけど、「賢くなったぶん、モデルの中で何が起きているかを見きるのが、以前より難しくなってきている」という方向の変化は、覚えておいて損はない。
見えない透かしが、初めて実際に入ったモデル
このサイトでは8月13日に、Claudeの生成テキストに見えない透かしが入るようになったという記事(claude-text-watermark)を出しました。あの記事では「2026年8月2日以降にリリースされたモデルは、最初から透かし入りになる」というAnthropicの方針を伝えていました。
実は、Fable 5.1・Mythos 5.1が、8月2日以降にリリースされた最初のClaudeモデルにあたります。つまり、3週間前の記事で書いた予告が、今回初めて実際のモデルで現実になったことになる。
透かしの仕組みは、ユーザー・組織・会話の内容そのものは含まれず、テキストとファイルの両方の出力に実装されています。検出APIは一般公開ではなく、規制当局・法執行機関・メディア・ファクトチェッカー・独立研究者といった、適格と認められた組織へ段階的に提供されます。8月の記事で書いた「今のところ一般ユーザーが検出する手段はない」という状況は、今回も変わっていません。
自分の使い方に当てはめる
ここまでの内容を、実際の仕事に当てはめてみます。カスタマーサポート業務でClaude Fable 5を使っていたBさんの例を追いながら、自分の状況を3列表に書き込んでほしい。
| 確認項目 | 具体例(Bさんの場合) | 自分に置き換える欄 |
|---|---|---|
| 主な使い方 | 問い合わせメールの一次回答を自動生成。1件ごとにナレッジベースをキャッシュ参照している | ____ |
| 今使っている設定 | high(回答の質を優先していた) | ____ |
| Fable 5.1へ替えた場合の見込み | mediumでも旧highと同等以上の質が出せそう。キャッシュ参照が多い使い方なので、コスト減の恩恵も出やすい | ____ |
| 判定 | 「軽い設定で足りる」かつ「キャッシュ参照が多い」=コスト減の側。乗り換える価値がある | ____ |
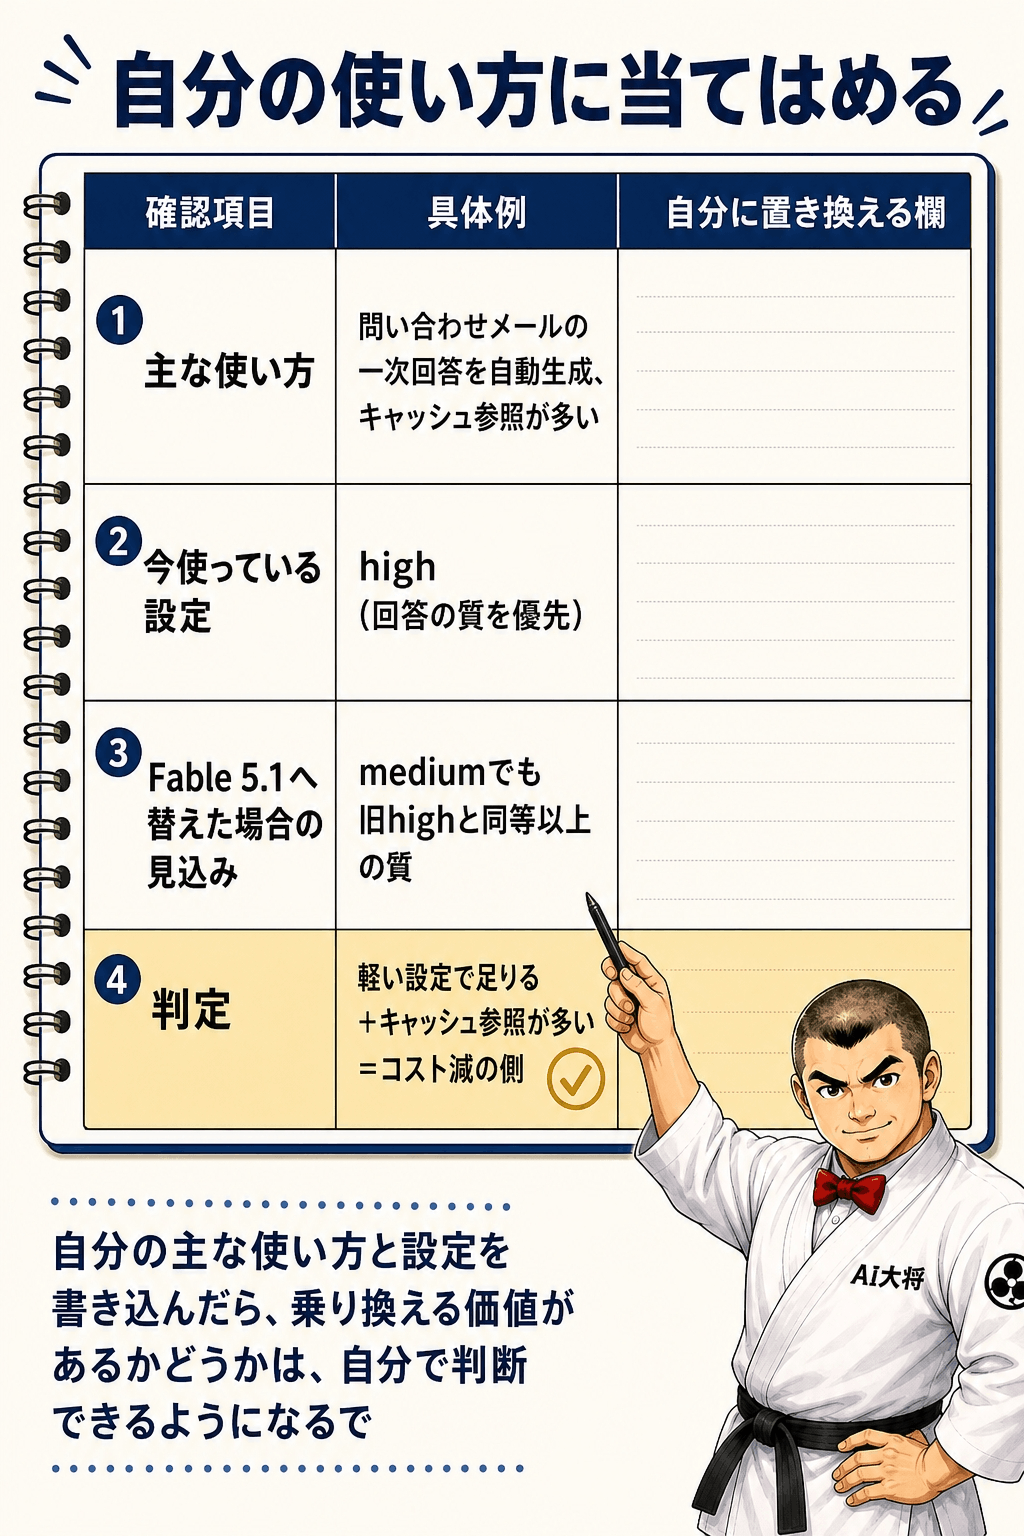
判定の目安は次の3つや。
- いつも最大設定を使う仕事は、コスト増を覚悟しておく
- 同じ質を、軽い設定で出せると分かっているなら、乗り換えでほぼ確実に得する
- どちらか分からない場合は、まず自分の主要タスクを1つ選んで、設定を1段階下げて試してみる。全部を一気に切り替える必要はない
APIを使っていない人(Claude Proなど)はどう読むか
ここまでAPIの価格を中心に説明してきたけど、Claude ProやMaxでモデルを選ぶだけの人にも、同じ判断の型がそのまま使える。
Claude.aiのモデル選択画面で「賢いほう」を選ぶか「速いほう」を選ぶか、というのは、実質的にはmax設定とmedium設定のどちらを使うかという選択と同じ構造をしています。いつも一番賢いモデルを選んでいる人は、応答が来るまでの時間や、利用回数の消費ペースが、Fable 5.1では以前より早く進む可能性があります。逆に、これまで速さを優先してSonnet系を使っていた人なら、Fable 5.1のmedium相当を試すことで、以前のFable 5・high相当に近い、あるいはそれ以上の結果を得られるかもしれへん。
料金プランそのものが値上がりしたわけやない。ただ、利用回数や応答時間の体感は、選ぶモデル・設定によって変わってくる、と覚えておいてほしい。
よくあるつまずき
総合点だけを見て乗り換えを決めてしまう
Intelligence Indexの66点という数字だけを見て「一番賢いから、これに全部切り替えよう」と決めるのは早い。測定条件(reasoning effort)が揃っていないこと、指数が比率で読める数字やないことを思い出してほしい。まずは自分がよく使うタスクで、実際に試すのが確実や。
「安くなった」を全タスクに当てはめてしまう
キャッシュ価格が75%下がったという事実だけを見て、請求額全体も同じ比率で下がると期待すると、実際には上がっていて驚くことになる。常に最大設定を使うタスクが多い場合は特に注意してほしい。
期間限定価格を年間計画に使ってしまう
Gemini 3.7 Flashの0.75ドル/3.75ドルは、2026年12月31日までの導入価格や。年をまたぐ計画を立てるなら、2027年以降の予定価格(1.50ドル/7.50ドル)で計算しておいたほうが安全になる。
監視懸念を無視してしまう
「監視がより難しくなっている可能性を示す弱い証拠」という表現は、断定やない。ただ、Anthropic自身が発表資料に明記している事実である以上、業務で重要な判断をモデルに任せきりにする場面では、頭の片隅に置いておいたほうがいい。
よくある質問
Claude Fable 5.1は本当に安くなったんですか
キャッシュ読み込みの単価は確かに75%下がっています。ただし第三者評価機関Artificial Analysisの実測では、平均タスクコストはFable 5より約20%上がったと報告されています。いつも最大設定を使うタスクが多い方は、実費が上がる可能性が高く、軽い設定で足りるタスクが多い方は、実際に安くなる可能性が高いです。
GPT-5.6やGeminiと比べて、結局どれが一番いいんですか
Artificial Analysis Intelligence Indexでは、2026年9月2日時点でClaude Fable 5.1が66点で最も高くなっています。ただしこの指数は測定条件(reasoning effort)が完全には揃っておらず、比率で読める数字でもありません。総合点だけで決めず、自分が重視する能力(コーディング・長文読解・大量処理など)に近いベンチマークを個別に確認することをおすすめします。
Claude Proプランでも使えますか
はい。Claude.aiではPro・Max・Team・Enterpriseのプランで利用できます。Freeプランは対象外です。
Fable 5は使えなくなるんですか
Anthropicは、Fable 5の提供終了時期を発表していません。Fable 5.1の登場によって、今後の主力モデルとしての位置づけは変わっていくと見られます。
「監視が難しくなっている」というのは、危険ということですか
Anthropicは「監視がより難しくなっている可能性を示す弱い証拠」と表現しており、危険と断定しているわけではありません。ただし、モデルの内部で何が起きているかを外から把握しづらくなっている方向の変化として、System Cardで正直に開示されています。
見えない透かしは、自分の仕事にどう影響しますか
Fable 5.1・Mythos 5.1で生成したテキスト・ファイルには、見えない透かしが最初から入っています。透かしはユーザー・組織・会話の内容を含みません。検出APIは規制当局やメディアなど適格な組織へ段階的に提供される形で、一般ユーザーが検出する手段は、この記事の時点ではまだありません。詳しくはclaude-text-watermarkで解説しています。
まとめ|今日決めること
Claude Fable 5.1は、Intelligence Indexで66点を取り、比較対象の192モデル中トップに立ちました。キャッシュ読み込み価格は75%下がった一方、Artificial Analysisの実測では平均タスクコストは約20%上がっています。この2つは矛盾やなく、「軽い設定で足りる仕事は安くなり、常に最大設定を使う仕事は高くなる」という条件の違いで両方とも正しい。
6月に一度全停止したFable 5・Mythos 5は、7月の再展開、追加インシデントの開示を経て、9月にさらに踏み込んだ統治機能を加えて戻ってきました。監視のしづらさという新たな懸念も、Anthropic自身が同じ発表資料で開示しています。
今日やることは一つでいい。上の3列表に、自分の主な使い方と、今使っている設定を書き込んでみてほしい。「軽い設定で足りるか」「キャッシュ参照が多いか」の2点が分かれば、乗り換える価値があるかどうかは、自分で判断できるようになる。
6月の停止の経緯を詳しく振り返りたい人は、こちらも合わせて読んでほしい。
Claude Fable 5・Mythos 5、リリース4日で全停止の記事を読む
総合点の配点や、ベンチマークの正しい読み方から知りたい人は、こちらが役に立つ。


