AIの性能ベンチマーク|総合点と値段。6モデルを並べたら順位が変わった
Claude Opus 5・GPT-5.6 Sol/Terra/Luna・Gemini 3.7 Flash・Claude Sonnet 5の6モデルを、Artificial Analysis Intelligence Indexと API料金で比較します。総合点の中身を開けると、エージェント関連が34%を占める配点でした。入力単価は25倍差、総合点は11ポイント差。どちらの言い方も成立しない理由を説明します。確認日は2026年8月19日です。

4回かけて、試験の中身を全部開けてきた。知識、推論、仕事をやり切る力、長い資料を読む力。最終回は、それを全部まとめた「総合点」と、値段の話や。「総合1位のモデルを選べばええんやろ」と思っとる人ほど、この記事で立ち止まってほしい。総合点の中身を開けたら、それは能力の順位やなくて、配点の話やった。
総合点の中身を、開けてみる
AIモデルの性能を1つの数字で表す指標として、Artificial Analysis Intelligence Index が広く引用されている。日本語の記事でも「AIの知能指数」として紹介されることが多い。でも、その中身の配点まで開けている記事は見当たらない。
2026年8月19日時点のIntelligence Index v4.1は、4カテゴリ・10評価の重み付き平均で構成されている。
| カテゴリ | 重み | 評価 |
|---|---|---|
| Agents | 34% | GDPval-AA v2(20%)/τ³-Bench Banking(14%) |
| Coding | 24% | Terminal-Bench 2.1(16%)/SciCode(8%) |
| Scientific Reasoning | 24% | HLE(12%)/GPQA Diamond(6%)/CritPt(6%) |
| General | 18% | AA-Omniscience Accuracy(8%)/AA-Omniscience Non-Hallucination Rate(4%)/AA-LCR(6%) |
この記事のシリーズでは基礎ナレッジの段階で「9項目」と紹介していたが、AA-Omniscienceが正答率(Accuracy)とハルシネーションのしなさ(Non-Hallucination Rate)の2つに分かれているので、実際は10評価になる。しかも単純に10個を並べて平均を取っとるわけやない。
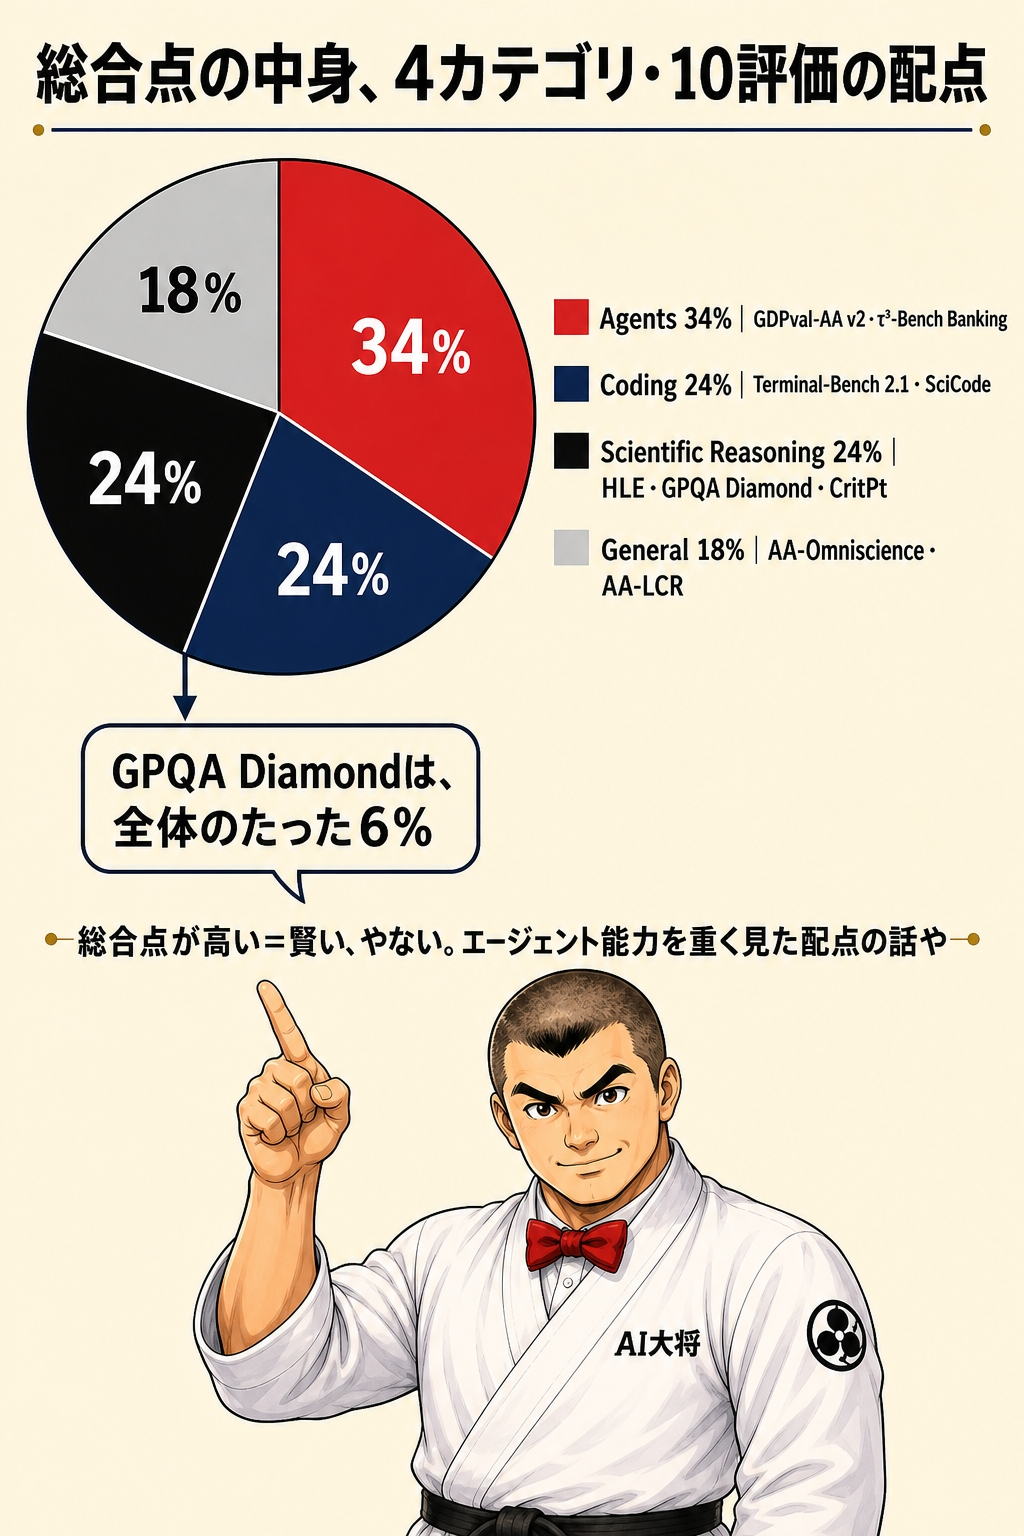
この円グラフ、見てすぐに気づくことがあるはずや。次の見出しで、それを説明する。
エージェントで34%、GPQA Diamondは6%
配点表をもう一度見てほしい。Agentsカテゴリだけで34%を占めている。GDPval-AA v2(実務タスクの遂行力)とτ³-Bench Banking(銀行業務を模したエージェントタスク)を合わせた数字や。
一方で、AI業界でいちばん引用されることが多いGPQA Diamond(専門家レベルの科学問題)は、たったの6%しかない。第2回で扱ったMMLU-Proや、第4回で扱ったAA-LCRも、それぞれ単体では大きな重みを持っていない。
これが意味するのは1つ。総合点が高い=賢い、やない。「いまのAI業界が、エージェント的にタスクをこなす能力を重く見ている」という配点の話や。あなたの仕事が、長時間かけて手順を進めるエージェント型の作業ではなく、一問一答的な質問への回答や知識の確認が中心なら、総合点の順位は、あなたの順位やない。
第1回で「ベンチマークの数字は割合であって絶対評価やない」と説明したのと、同じ構造がここにも出てくる。総合点は、10種類の試験結果を1つの配点表で足し合わせた合成値であって、あなたの仕事に対する成績表やない。
単純平均やない。1つだけEloから変換されとる
配点の話に加えて、もう1つ押さえておきたいことがある。Intelligence Indexは単純平均やなく、重み付き平均で算出されている。
大半の評価はpass@1(1回目の試行で正解した割合)や正答率をそのまま0〜100%の数値として使う。しかしGDPval-AA v2だけは違う。この評価はEloレーティング(対戦形式の強さを表す数値)をベースにしていて、clamp((Elo − 500) / 2000) という計算式で0〜1の範囲に正規化してから、他の評価と同じ土俵に乗せている。
つまり総合点は、そこまで作り込まれた合成値になる。異なる物差しで測った10個の数字を、それぞれ別の方法で0〜100%に揃えたうえで、重みをかけて足し合わせたものが「63点」や「52点」という1つの数字になっている。この作り込みを知っとくと、総合点を鵜呑みにする危うさが分かってくるはずや。
IFBenchは、飽和したから外された
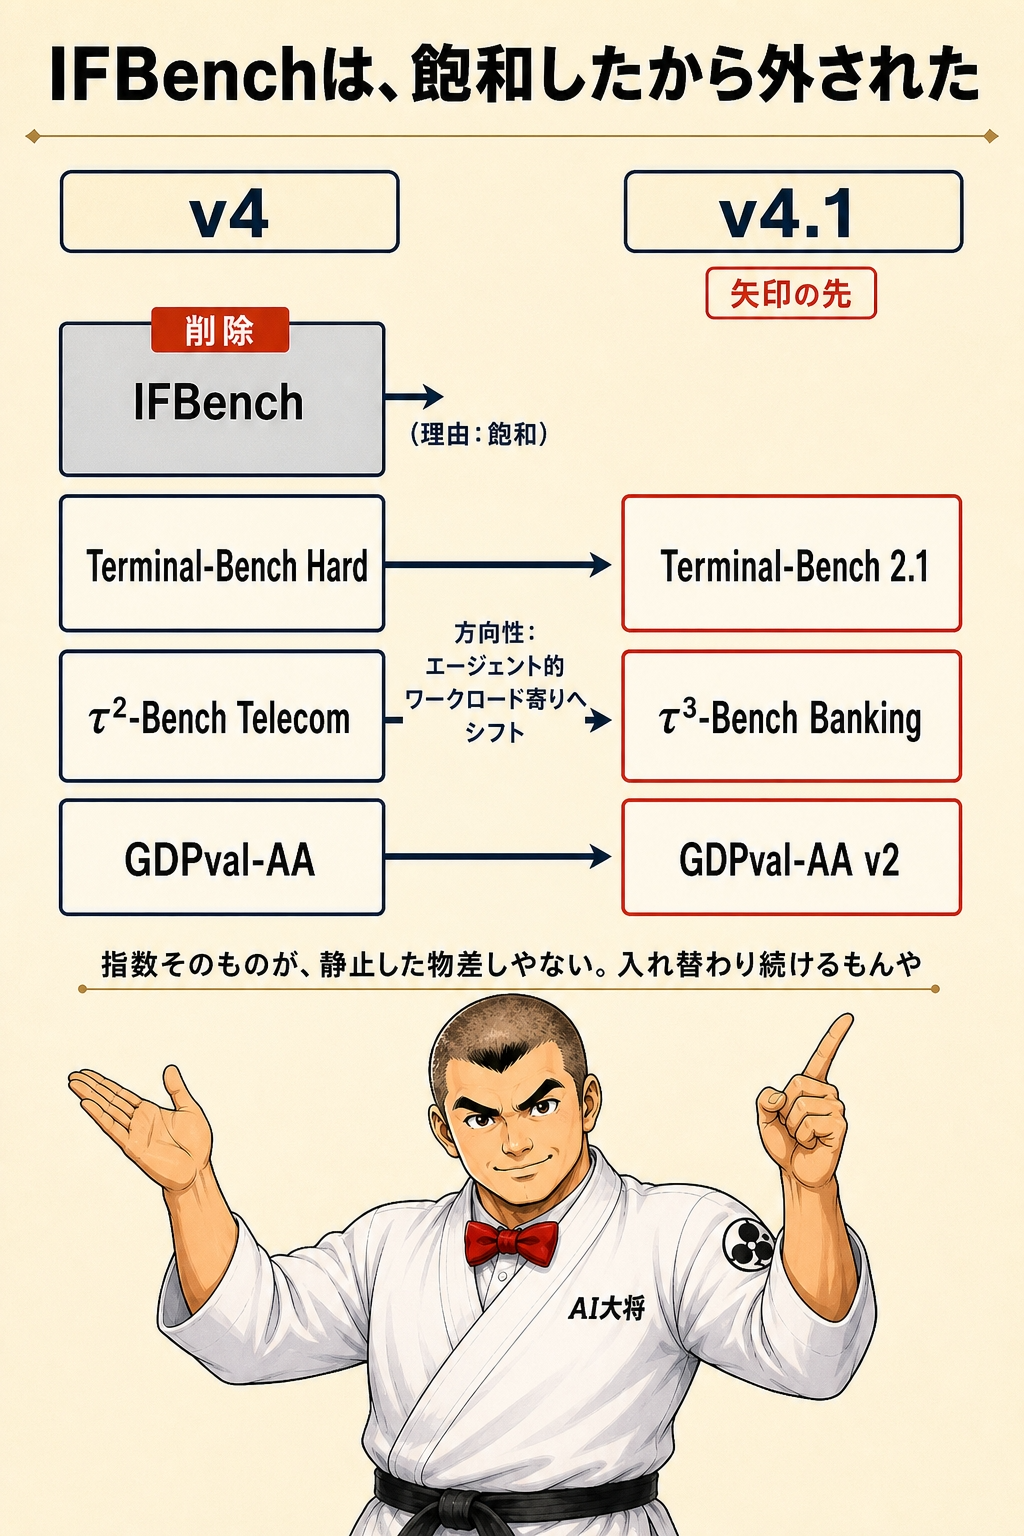
配点だけやなく、Intelligence Indexそのものも、時期によって中身が変わっている。2026年8月19日時点の最新はv4.1.1やが、直前のv4からどう変わったかを見ておく。
| 種別 | 内容 |
|---|---|
| アップグレード | Terminal-Bench Hard → Terminal-Bench 2.1/τ²-Bench Telecom → τ³-Bench Banking/GDPval-AA → GDPval-AA v2 |
| 削除 | IFBench。理由は「飽和」。フロンティアモデル同士を十分に区別できなくなったため |
| 方向性 | エージェント的ワークロード寄りへのシフト |
| 重み | 既存の評価も含めて再配分 |
「飽和したから外した」という事実は、第1回で書いた「テストには寿命がある」ことの、決定的な実例になる。IFBench(指示遵守を測る試験)は、フロンティアモデルがほぼ全問正解に近づいてしまい、モデル同士の差を測れなくなった。だから配点から消えた。
指数そのものが、静止した物差しやない。入れ替わり続けるもんやと思っといたほうがええ。
採点する側のAIも、入れ替わっとる
v4.1からv4.1.1への変更では、評価項目そのものは変わっていない。変わったのは採点する側や。HLE・AA-LCR・AA-Omniscienceの3つは、正解かどうかをAIが判定する形式の試験で、その採点役をGPT-5.6 Luna(medium設定)に統一した。以前はHLEがGPT-4o、AA-LCRがQwen3 235B、AA-Omniscienceが Gemini 3 Flash Preview と、評価によって採点役がバラバラやった。統一した理由は、人間の判断との一致度が高かったためとされている。
τ³-Bench Bankingについても、Sierraのv1.0.1へ更新され、不調な経路から復帰した軌跡を誤って不正解と判定していたエラーが解消された。この変更によるスコアの変動は、ほとんどのモデルで1ポイント未満。最大でもMuse Spark 1.2の+2.7ポイントにとどまる。
同じ「Intelligence Index」という名前の指数でも、時期が違えば採点の条件が違う。過去の記事や他サイトの数字と、今この記事の数字を単純に並べて比較したらあかん。
6モデルを並べる(2026年8月19日時点)
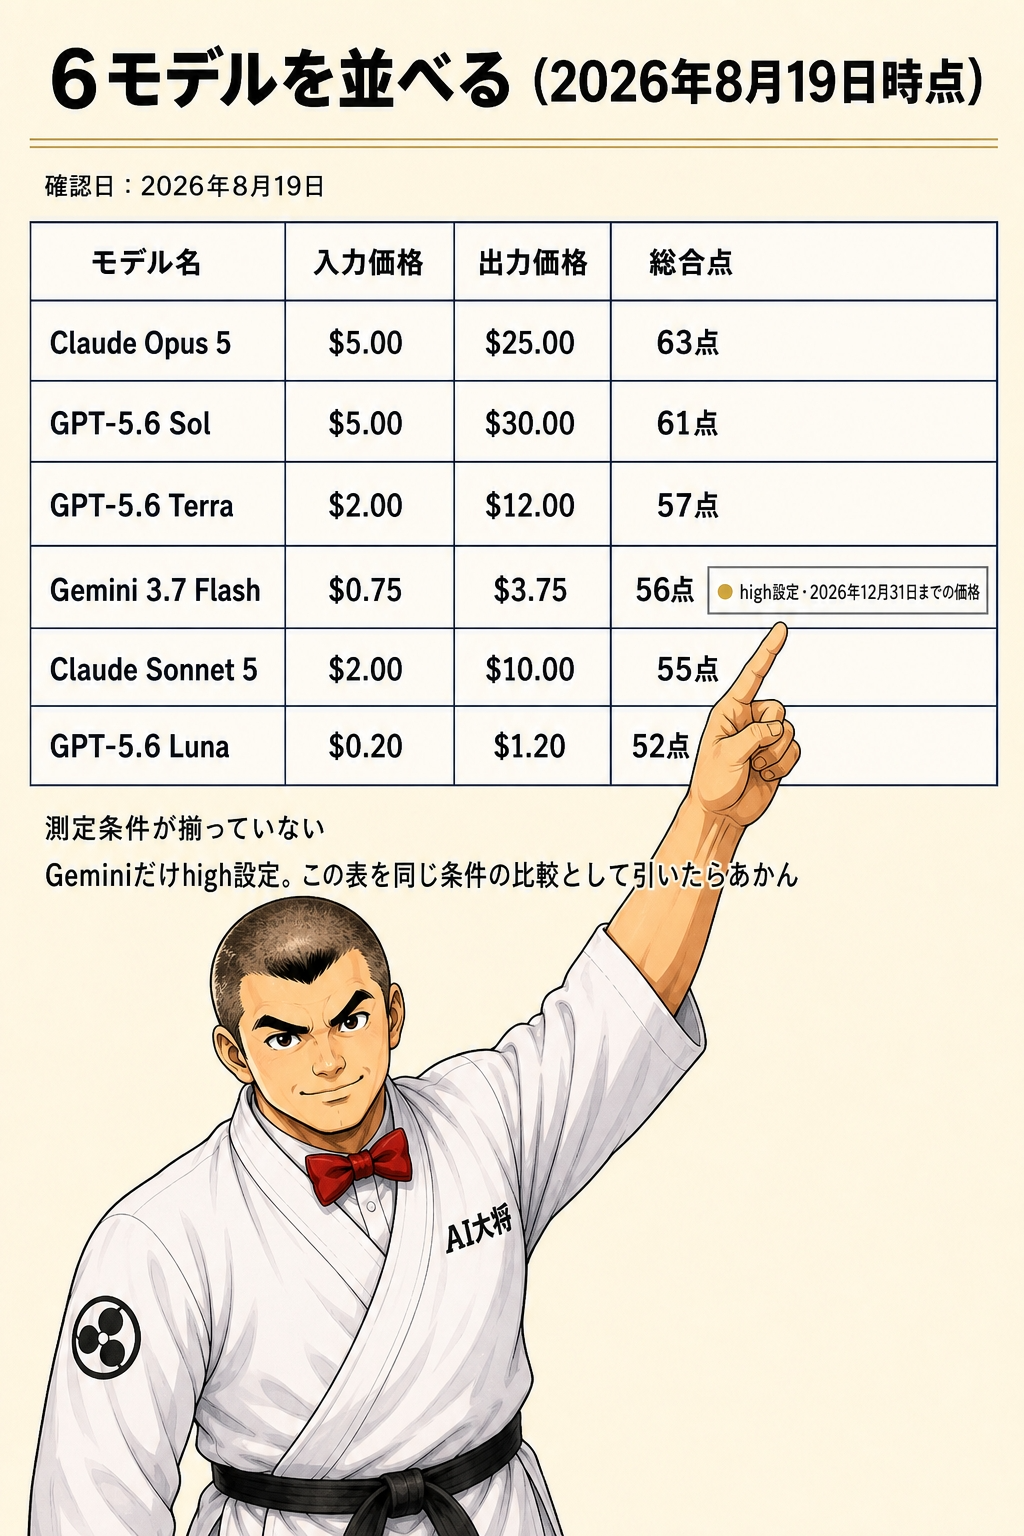
確認日:2026年8月19日。ここから先の数値は、すべてこの日時点のものになる。
| モデル | 入力(100万トークン) | 出力(100万トークン) | AA Intelligence Index | 設定 |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $25.00 | 63 | max |
| GPT-5.6 Sol | $5.00 | $30.00 | 61 | max |
| GPT-5.6 Terra | $2.00 | $12.00 | 57 | max |
| Gemini 3.7 Flash | $0.75(期間限定) | $3.75(期間限定) | 56 | high |
| Claude Sonnet 5 | $2.00 | $10.00 | 55 | max |
| GPT-5.6 Luna | $0.20 | $1.20 | 52 | max |
この表、ここが大事なとこや。Gemini 3.7 Flashだけ「high」設定で、それ以外の5モデルは「max」設定になっとる。reasoning effort(AIがどれだけ深く考えてから答えを出すかの設定)は、モデル名の後ろに括弧で明記される形で、同じモデルでも設定が違えば別のエントリとして並列に掲載される。今回の6モデルの並びは、各モデルが公表している中でいちばん高い性能を出せる設定を選んで揃えたものやけど、Geminiだけは1段階下の設定になっている。つまり、この表を「まったく同じ条件で測った比較」として読んだらあかん。総合順位を見るための第三者比較としては使えるが、絶対的な能力差として断定する材料やない。
値段を横に置いたら、話が変わる
総合点だけ見ていると気づきにくいが、値段を横に並べると、話がもう一段変わる。入力と出力の単価を、それぞれ分けて見ていく。
| モデル | 入力単価 | 出力単価 | Index |
|---|---|---|---|
| Claude Opus 5 | $5.00 | $25.00 | 63 |
| GPT-5.6 Luna | $0.20 | $1.20 | 52 |
入力単価はOpus 5とLunaで25倍差。総合点は11ポイント差。この2つの数字が、まったく違うスケールで並んどるのが、この記事のいちばんの山場や。
「83%の性能」も「25倍優秀」も、両方まちがい
ここで、ついやってしまいそうな計算がある。「52は63の何%だから、Lunaは83%の性能」という言い方。もう1つは、「入力単価が25倍違うんだから、Opus 5はLunaの25倍優秀」という言い方。
どちらの言い方も成立せえへん。Intelligence Indexは、比率で読む数字やない。63と52は、10種類の評価をそれぞれ別の方法で0〜100%に正規化し、重みをかけて足し合わせた合成値であって、絶対的な原点(0点が「まったく何もできない」を意味するような基準)を持った物差しやない。だから割り算して「何倍」「何%」と言うこと自体が、この指数の作られ方と噛み合っていない。
言えるのは「63と52で、11ポイントの差がある」という事実だけ。それが実務でどれだけの差になるかは、あなたの仕事の内容によって変わる。
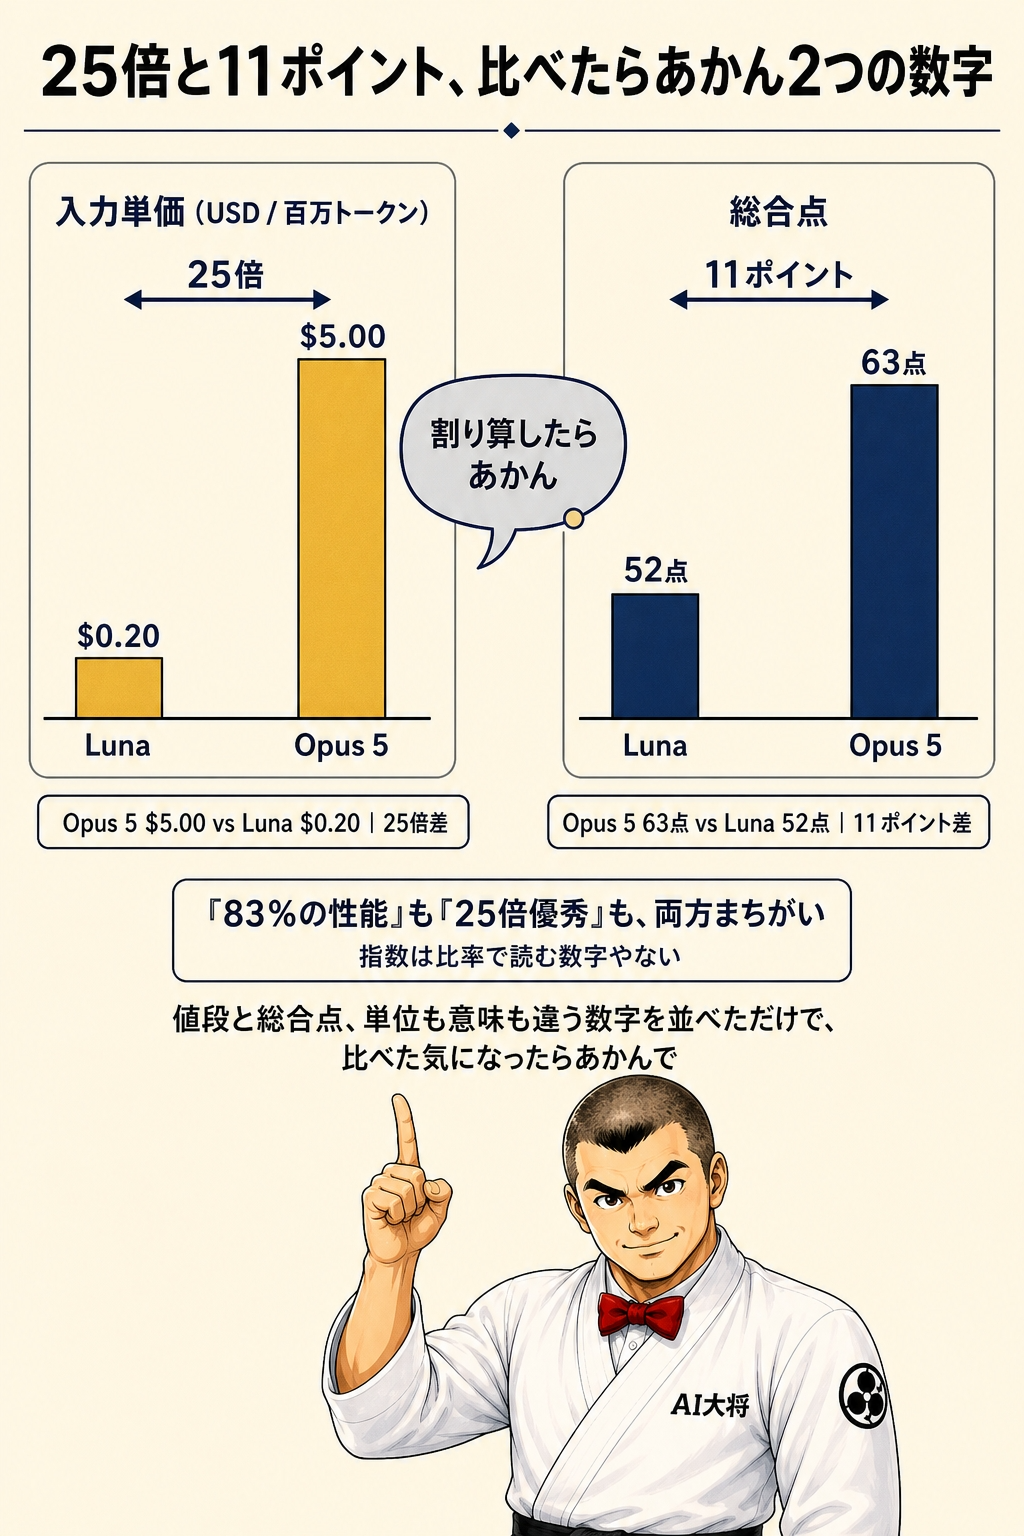
25倍と11ポイント、この2つの数字を同じ土俵で語ったらあかんで。片方は値段、片方は合成された指数。単位も意味も違う数字を並べただけで、比べた気になったらあかん。
1,000万トークン流したら、いくらか
単価だけやとピンと来ないので、実際にまとまった量を流した場合で見てみる。1,000万トークンを入力した場合の単純計算(キャッシュ機能などは考慮しない)は次のとおり。
| モデル | 100万トークン | 1,000万トークン |
|---|---|---|
| Claude Opus 5 | $5.00 | $50.00 |
| GPT-5.6 Sol | $5.00 | $50.00 |
| Claude Sonnet 5 | $2.00 | $20.00 |
| GPT-5.6 Terra | $2.00 | $20.00 |
| Gemini 3.7 Flash | $0.75 | $7.50 |
| GPT-5.6 Luna | $0.20 | $2.00 |
$50.00と$2.00。桁が変わる。ただし、この表には「失敗してやり直した回数」は入っていない。後半で、その話をする。
いつまでその値段か、を見る
さっきの表を見て「Gemini 3.7 Flashが最も安価」と思った人もおるやろう。ここで、もう1つ確認しといてほしいことがある。
| 項目 | 内容 |
|---|---|
| GPT-5.6の値下げ | 2026年7月30日に実施。Terraは20%値下げ、Lunaは80%値下げ |
| Claude Sonnet 5 | 当初は導入価格として提示され、その後恒久価格化 |
| Gemini 3.7 Flash | 2026年8月13日リリース。$0.75/$3.75の価格は2026年12月31日までの導入価格 |
Gemini 3.7 Flashの$0.75/$3.75は、2026年12月31日までの導入価格や。終了後の予定価格は、Googleが公表している数値で入力$1.50・出力$7.50になる。つまり年をまたいだ瞬間、単価が倍になる予定になっとる。
年内だけ使う計画なら、いまの価格でええ。でも年をまたぐ計画を立てるなら、倍の価格で試算しといたほうがええ。GPT-5.6の数字も、2026年7月30日の値下げ後の価格やということを忘れんとってほしい。発売時の価格を引用した古い情報が、まだネット上には残っとる。
単価やなく、1件終わらせるのにいくらか
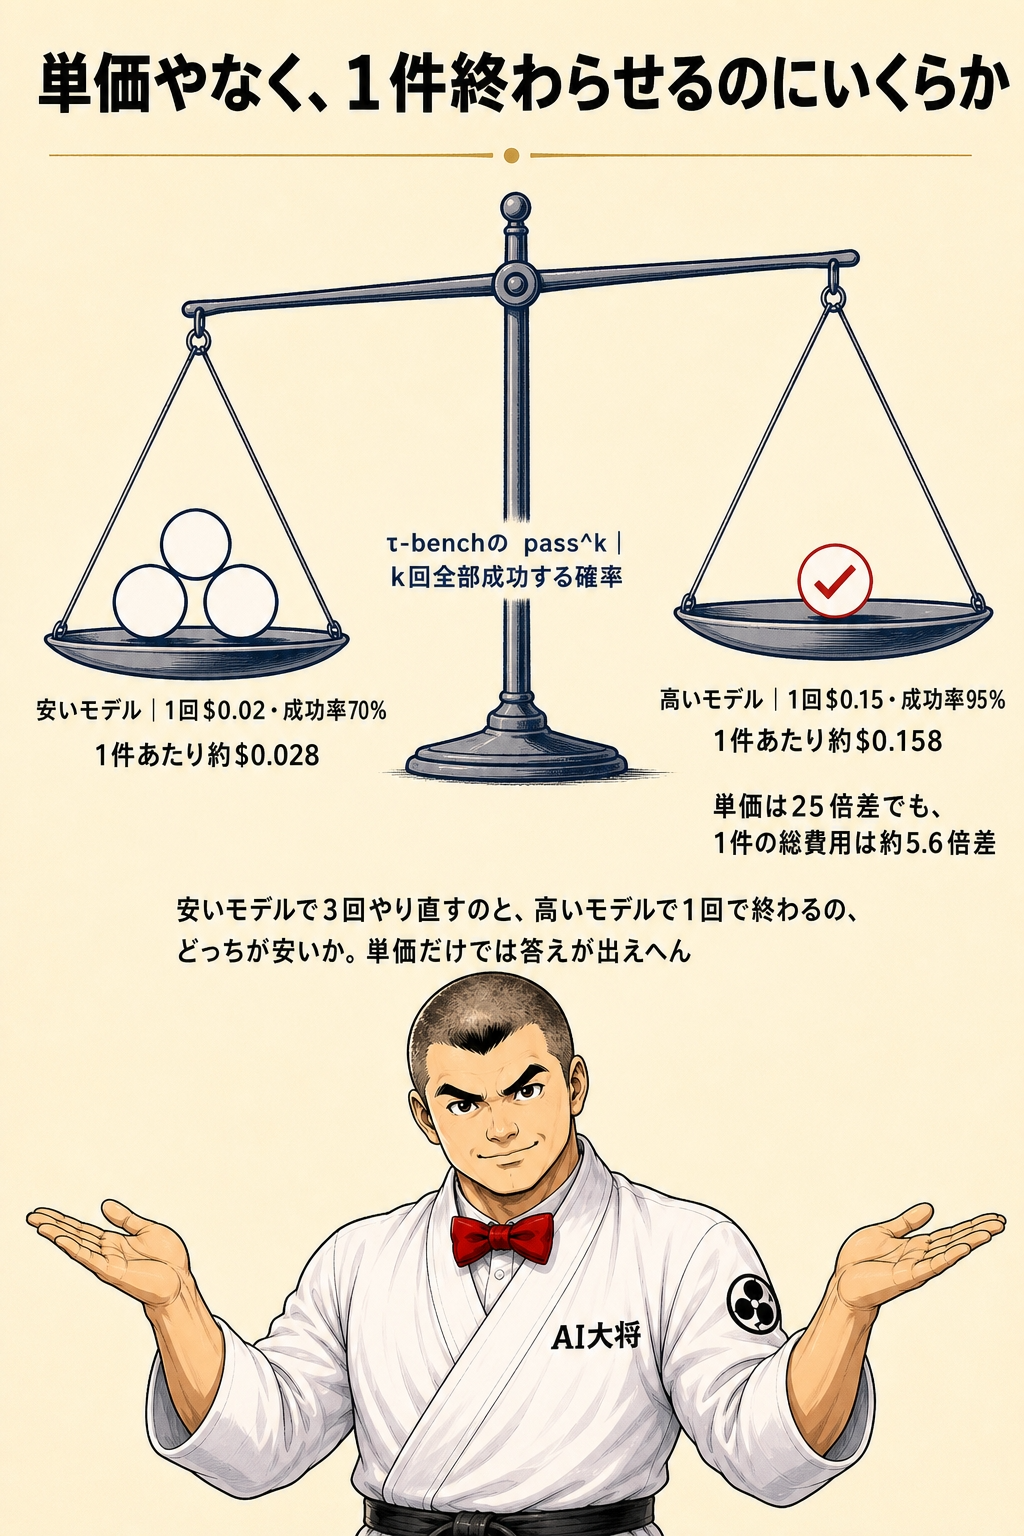
第3回で扱ったτ-benchのpass^k(k回の試行がすべて成功する確率)を、ここでもう一度思い出してほしい。安いモデルで3回やり直すのと、高いモデルで1回で終わるの、どっちが安いか。
単価だけを見た計算では、答えは出えへん。仮に、ある作業をLunaで実行すると1回$0.02かかり、成功率が70%だとする。3回に1回は失敗して、もう一度やり直す前提で考えると、平均して1.4回ぶんの試行が必要になる。1件あたりの実費は約$0.028になる。一方、Opus 5で同じ作業を実行すると1回$0.15かかるが、成功率が95%あるとする。平均試行回数は約1.05回で、1件あたりの実費は約$0.158になる。
この例だと、単価が25倍近く違っても、1件を終わらせる費用で見ると約5.6倍の差にしかならへん。逆に言うと、失敗率が高い作業を安いモデルへ任せると、思っとったほど安くならへんこともある。
判断の軸は、単価やなく「1件を正常に終わらせるまでの総費用」に置く。これは2026年6月11日に公開した記事「GPT-5.6 Lunaの値下げと、1件正常完了当たりの費用」で書いた考え方そのものが、このシリーズの結論として、ここに戻ってきている。
APIを使ってへん人は、どう読むか
ここまでAPI料金の話が続いたけど、「うちはAPIなんて使こてへん、ChatGPTやClaudeをそのまま使こてるだけや」という人にも、この記事は関係がある。
ChatGPTやClaude、Geminiのアプリには、モデル選択画面がある。「速いモデル」と「じっくり考えるモデル」を選べるようになっとって、これはAPIの料金プランを選ぶのと、まったく同じ構造の判断になっとる。速いモデルは安く(あるいはサブスクの利用回数制限が緩く)、じっくり考えるモデルは重い分だけコストが高い。
サブスクを使こてる人にとっての「コスト」は、お金やなくて時間や回数制限になる。安いモデルで3回やり直す時間と、高いモデルで1回で終わらせる時間、どっちが自分にとって得か。この記事で説明した判断の型は、そのままサブスクのモデル選択画面でも使える。
「APIを使う方は参考にしてください」という書き方は、この記事ではせえへん。読者の大半が、そこで離脱してしまうからや。API利用者もサブスク利用者も、判断の軸は同じところにある。
モデル選びの1枚が、完成する
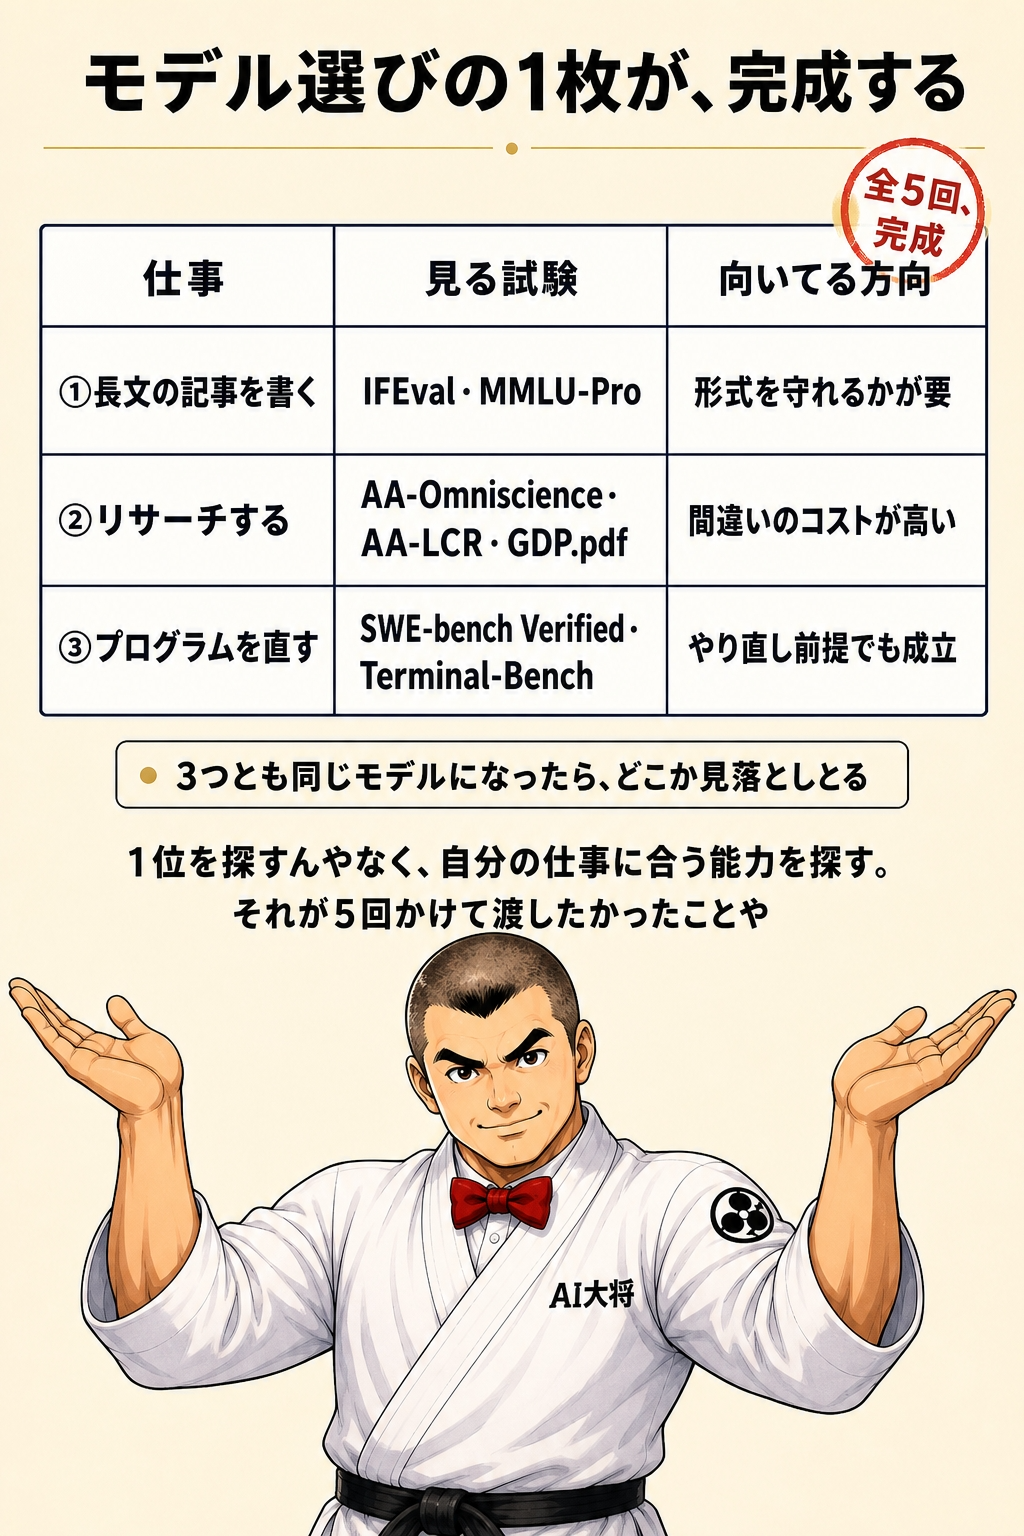
第1回で「うちの仕事、3つ書き出してみよか」と始めた3行表。第2回でリサーチ系の試験を、第4回で長文・画像を読む試験を埋めてきた。最終回の今日、価格と総合点を加えて、全列を完成させる。
| 仕事 | 見る試験(第2〜4回) | 向いてる方向 |
|---|---|---|
| ① 長文の記事を書く | IFEval(指示遵守)+MMLU-Pro(幅広い知識) | 形を守れるかが要になる。総合点の高さより、指示遵守を見る |
| ② リサーチする | AA-Omniscience(知ったかぶりせんか)+AA-LCR(複数資料の統合)+GDP.pdf(専門PDF) | 間違いのコストが高い。ここは高いモデルを使う価値が出やすい |
| ③ 作ったプログラムを直す | SWE-bench Verified+Terminal-Bench | 失敗しても直せる。やり直し前提なら、安いモデルで回数を稼ぐ選択もある |
判定の軸は、次の4つに集約される。
失敗したときのコストが高い仕事は、総合点の高いモデルを選んで1回で終わらせる。量が多くて、やり直しがきく仕事は、単価の安いモデルを選んで回数で解決する。形式を守ってほしい仕事は、総合点やなくIFEvalのようなピンポイントの試験を見る。そして、3つの仕事が全部同じモデルになったなら、どこかで見落としがある。①は形を守る力、②は間違えない力、③はやり直しがきく前提の力。求めとる能力が違う以上、選ぶモデルも揃わへんのが自然や。
新しいモデルが出たら、この1枚のどこを直すか
- その仕事に効く試験を思い出す(第2〜4回で扱ったIFEval・MMLU-Pro・AA-Omniscience・AA-LCR・SWE-bench Verified・Terminal-Bench)
- 総合点やなく、その試験だけのスコアを見にいく
- 価格は入力と出力を分けて確認する
- 期間限定価格かどうかを見る。「導入価格」「キャンペーン」の表記がないか確認する
- 単価やなく、1件終わらせる費用で比べる
新モデルが出るたびに、この5手順を1枚のメモへ当てはめれば、また判断ができる。総合点のランキングを毎回追いかける必要はない。
最後に、やったらあかんこと
総合点だけで選ぶ
総合点はAgentsカテゴリが34%を占める配点で作られている。あなたの仕事がエージェント型でないなら、総合点の順位はあなたの順位やない。
指数を割り算する
63と52を「83%の性能」と表現したり、価格差から「25倍優秀」と表現したりしてはいけない。Intelligence Indexは重み付き平均の合成値であって、比率で読む数字やない。
条件が揃ってへん表を「同条件」として引く
今回の6モデルの表は、Gemini 3.7 Flashだけhigh設定、他はmax設定になっている。この違いを無視して、単純な能力差として引用してはいけない。
期間限定価格で年間計画を立てる
Gemini 3.7 Flashの$0.75/$3.75は2026年12月31日までの価格。年をまたぐ計画では、予定されている$1.50/$7.50で試算しておく。
確認日を書かずに数字を出す
AIモデルの価格とスコアは動く。この記事の数値は2026年8月19日時点のもの。数字を引用するときは、確認した日付を必ず添える。
よくある質問
総合点がいちばん高いモデルを選べば間違いないですか
間違いとは言い切れませんが、最適とも言えません。総合点はAgentsカテゴリが34%を占める配点で作られています。長文作成やリサーチが中心の仕事なら、総合点よりIFEvalやAA-Omniscienceのような、仕事に直結する試験のスコアを見たほうが実態に近づきます。
Intelligence Indexの63と52は、性能が何倍違うということですか
何倍という比較はできません。この指数は10種類の評価を別々の方法で0〜100%に正規化し、重みをかけて足し合わせた合成値です。原点が「性能ゼロ」を意味する物差しではないため、割り算して比率を出すこと自体が指数の作られ方と噛み合いません。差として読めるのは「11ポイント差がある」という事実だけです。
Gemini 3.7 Flashが安いうちに乗り換えたほうがいいですか
年内だけの利用なら、いまの$0.75/$3.75で試算して問題ありません。ただし2026年12月31日を過ぎると、予定価格は$1.50/$7.50になります。年をまたぐ計画があるなら、倍の価格で試算しておいたほうが、後で慌てずに済みます。
APIを使っていないのですが、この記事は関係ありますか
関係があります。ChatGPTやClaude、Geminiのモデル選択画面で「速いモデル」と「じっくり考えるモデル」を選ぶのは、API料金プランを選ぶのと同じ構造の判断です。安いモデルで3回やり直す時間と、高いモデルで1回で終わらせる時間、どちらが自分にとって得かという軸は、サブスク利用者にもそのまま使えます。
安いモデルで何回もやり直すのと、高いモデルで1回やるのは、どちらが得ですか
作業の成功率によって変わります。単価が25倍違っても、成功率の差が小さければ、1件を終わらせる総費用の差はそこまで開きません。逆に失敗率が高い作業を安いモデルへ任せると、やり直しの回数が増えて、思ったほど安くならないことがあります。単価ではなく、1件正常完了あたりの費用で比べてください。
この記事の数字は、いつまで有効ですか
確認日は2026年8月19日です。AIモデルの価格改定やIntelligence Indexの評価項目の入れ替えは、今後も起こります。新しいモデルが出たときは、この記事で紹介した5つの手順で、自分のメモを更新してください。
5回ぶん、これで終わりや
「AIの性能ベンチマークの読み方」、これで5回、全部書き切った。第1回でベンチマークが割合の話やと確認し、第2回で知識と推論の8つの試験を、第3回で仕事を最後までやり切る力の8つの試験を、第4回で大量の資料と画像を読む力の9つの試験を、それぞれ4行の型で開けてきた。最終回の今日は、それを全部まとめた総合点と、値段の話をした。
読み始めた頃は「どのAIがいちばん強いか」を知りたかった人も、ここまで読んだら分かってもらえたと思う。「1位を探す」から「自分の仕事に合う能力を探す」へ、見方が変わったはずや。総合点のランキングに振り回されず、自分の3行表を、これからも更新していってほしい。


